Considero que la parte más difícil de implantar inteligencia artificial (o Super Inteligencia, como le están empezando a llamar) suele estar al principio: conseguir que una idea prometedora deje de ser una demo y empiece a comportarse como software de producción. Entender cómo pasar un piloto de IA a producción en una empresa exige convertir una prueba controlada en un proceso repetible, integrado y supervisado. Hay que delimitar entradas y salidas, trabajar con datos reales, gestionar permisos, contemplar fallos, registrar acciones, definir intervención humana y medir el resultado frente a una línea base.
El cambio parece pequeño desde fuera. El modelo que clasificaba documentos en el piloto sigue clasificando documentos. Sin embargo, alrededor aparecen usuarios reales, APIs que tardan demasiado, campos nulos, credenciales caducadas, duplicados, costes variables, excepciones y sistemas de registro que no pueden tratarse como una base de datos de pruebas. Una automatización de procesos con IA preparada para producción se parece menos a una demo espectacular y más a cualquier sistema distribuido construido con disciplina de ingeniería.
En este artículo vamos a recorrer ese camino desde la perspectiva de proceso: qué diferencia una demo de una implantación, cómo delimitar el caso de uso, gobernar datos, integrar CRM y ERP, diseñar control humano, medir resultados y mantener el sistema después del despliegue. Porque el modelo es una pieza importante, pero no ejecuta el proceso él solo.
Por qué una demo no equivale a un proceso implantado
Idea clave: Una demo demuestra que el modelo puede resolver una tarea bajo unas condiciones concretas. Producción debe demostrar que el proceso puede repetirla con datos variables, usuarios reales, permisos, integraciones, fallos y costes controlados. La diferencia está menos en la inteligencia aparente del modelo que en todo el sistema construido alrededor.
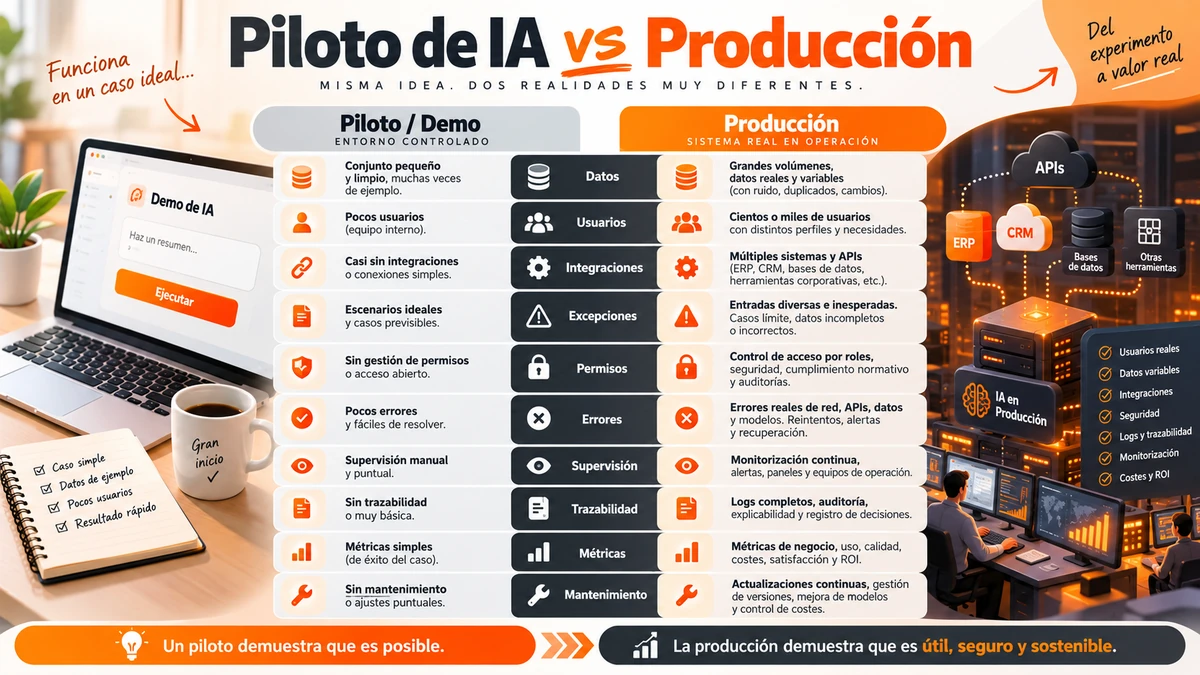
Una demostración está diseñada para reducir incertidumbre. Seleccionas documentos adecuados, preparas los datos, controlas quién prueba el sistema y sabes aproximadamente qué entradas recibirá. Si hay un fallo, alguien abre la consola, corrige el registro y vuelve a ejecutar. Para validar una hipótesis es perfectamente razonable.
Producción elimina buena parte de ese acolchado. El formulario recibe información que nadie esperaba, un usuario introduce caracteres extraños, el CRM devuelve un campo vacío, el proveedor cambia una API o dos peticiones intentan modificar el mismo registro. Son problemas clásicos de software. UNIX ya nos enseñó hace décadas que los sistemas reales viven rodeados de procesos, permisos, entradas imprevisibles y fallos parciales. Añadir un LLM no deroga esas leyes.
La investigación sobre LLMOps describe precisamente esta diferencia de escala: operar modelos de lenguaje añade necesidades específicas de despliegue, monitorización, infraestructura, integración, versionado, seguridad y mantenimiento durante su ciclo de vida (Pahune & Akhtar, 2025).
Un piloto puede resultar convincente y fracasar como proceso por situaciones bastante prosaicas:
- recibe un documento incompleto y no sabe qué hacer;
- genera correctamente una salida, pero falla la escritura posterior en el ERP;
- reintenta una petición y crea el mismo registro dos veces;
- utiliza información a la que el usuario no debería tener acceso;
- encuentra un caso ambiguo y no dispone de ruta de derivación;
- cambia el comportamiento después de una actualización del proveedor;
- ejecuta una acción válida técnicamente, pero incorrecta para ese contexto;
- no conserva datos suficientes para reconstruir lo ocurrido.
Aquí aparece una distinción útil: capacidad frente a operabilidad. Un modelo puede tener capacidad para extraer campos de una factura. La operabilidad consiste en conseguir que esa extracción funcione miles de veces, con versiones distintas de documentos, permisos reales y mecanismos de recuperación cuando una dependencia falla.
Una prueba técnica suele responder a «¿puede hacerlo?». El sistema productivo debe responder a otra batería de preguntas: «¿cuándo puede hacerlo?», «¿con qué datos?», «¿quién lo autoriza?», «¿qué ocurre si falla?» y «¿cómo reconstruimos la ejecución tres semanas después?».
IA en producción · diferencias operativas
Del piloto controlado al proceso real de producción
Una demostración de IA puede funcionar bien en condiciones acotadas y, aun así, fallar al integrarse en un proceso real. La diferencia aparece cuando entran en juego datos cambiantes, usuarios diversos, permisos, excepciones, errores y necesidades de trazabilidad.
| Variable | Demo o piloto | Producción |
|---|---|---|
| Datos | Seleccionados, preparados o acotados. | Reales, cambiantes, incompletos y sujetos a permisos. |
| Usuarios | Grupo pequeño y familiarizado con la prueba. | Usuarios habituales con comportamientos diversos. |
| Integraciones | Simuladas, parciales o de solo lectura. | CRM, ERP, web, bases de datos y APIs reales. |
| Excepciones | Limitadas o corregidas manualmente. | Identificadas, registradas, derivadas y recuperables. |
| Permisos | Simplificados. | Roles, scopes y mínimo privilegio. |
| Errores | Intervención manual directa. | Retries, colas, estados, compensación y rollback. |
| Supervisión | Informal. | Responsabilidades y criterios definidos. |
| Trazabilidad | Logs de desarrollo. | Registro reconstruible de entradas, versiones, decisiones y acciones. |
| Métricas | Viabilidad del concepto. | Rendimiento frente a una línea base y umbrales acordados. |
| Mantenimiento | Puntual. | Ciclo continuo de revisión, pruebas y versionado. |
La diferencia entre probar IA y operarla en producción está en el entorno: el piloto demuestra que una idea puede funcionar bajo condiciones controladas; producción exige que siga funcionando cuando los datos cambian, aparecen excepciones, intervienen sistemas reales y cada acción debe poder supervisarse y reconstruirse.
Delimitar el caso de uso: tarea, usuarios, entradas, salidas y excepciones
Qué debes saber: Antes de conectar un modelo a un proceso empresarial necesitas describir ese proceso como si fueras a programarlo sin IA: evento inicial, participantes, entradas, salida, estados, sistemas afectados, permisos y excepciones. Cuanto más difusa sea la especificación, más difícil será controlar el comportamiento cuando lleguen casos reales.
El primer artefacto útil para pasar de piloto a producción no es otro prompt. Es un mapa del proceso.
Empieza por el evento que inicia la ejecución. Puede ser un formulario enviado desde una web, un correo recibido, un cambio de estado en el CRM, la subida de un contrato o un webhook emitido por otra aplicación. Ese evento debe producir una transición identificable: existe un estado anterior, ocurre algo y el sistema pasa a un estado posterior.
Después hay que determinar quién consume el resultado. No produce las mismas consecuencias un resumen que verá un empleado que una instrucción enviada directamente a un ERP. En el primer escenario, una persona todavía puede detectar un error antes de que produzca efectos. En el segundo, la salida del sistema puede modificar el estado operativo del negocio.
Reglas deterministas frente a interpretación
Uno de los errores más caros consiste en introducir un modelo generativo donde bastaría una condición programada. Si una factura superior a cierto importe siempre necesita aprobación, un if sigue siendo una pieza de tecnología extraordinariamente competente.
La IA aporta valor cuando la entrada requiere interpretar significado o manejar variabilidad:
- clasificar mensajes redactados de formas diferentes;
- extraer información de documentos no estructurados;
- resumir expedientes;
- identificar intención;
- relacionar contexto repartido entre varias fuentes;
- generar un borrador sujeto a restricciones;
- tratar lenguaje natural que no encaja en reglas cerradas.
Al diseñar una automatización de procesos con IA, separar estas tareas de las reglas deterministas evita crear una arquitectura probabilística donde una función convencional resolvería el problema con menos coste, menor latencia y mayor facilidad de auditoría.
Antes de automatizar, responde estas preguntas
- ¿Qué acontecimiento inicia exactamente el flujo?
- ¿Qué usuarios o sistemas participan?
- ¿Qué información necesita el modelo y de dónde procede?
- ¿Cuál es el formato de salida esperado?
- ¿Qué sistemas puede consultar y cuáles puede modificar?
- ¿Qué operaciones tiene expresamente prohibidas?
- ¿Qué casos deben detener el proceso?
- ¿Cuándo debe derivarse la ejecución a una persona?
Esta especificación también debería contener los estados del proceso. Por ejemplo:
recibido → validando → analizado → pendiente_aprobacion → aprobado → enviado
Añadir estados explícitos puede parecer algo muy «base de datos de los noventa», pero sigue resolviendo un problema fundamental: saber dónde está cada ejecución y qué transiciones son legítimas. Los nombres pueden cambiar; el principio permanece.
Si un modelo encuentra información contradictoria, el resultado correcto quizá no sea «intentar responder mejor». Puede ser colocar la ejecución en pendiente_revision. Diseñar esa salida de antemano es considerablemente más seguro que descubrirla después del primer incidente.
Revisar datos: calidad, permisos, actualización y trazabilidad
Idea clave: Un modelo en producción debe evaluarse junto con los datos que consume. Necesitas conocer su procedencia, comprobar su calidad, limitar el acceso según permisos y conservar información suficiente para reconstruir una ejecución. Sin ese contexto puedes obtener respuestas plausibles cuyo origen, vigencia o autorización resulte imposible demostrar después.
El modelo recibe información, pero el proceso necesita saber qué información recibió. Esta diferencia adquiere especial importancia con arquitecturas RAG, bases documentales, CRM, ERP o repositorios compartidos.
Una política antigua, un registro duplicado o un documento que el usuario no debería consultar pueden acabar formando parte del contexto del modelo. Si eso ocurre, perfeccionar el prompt no arregla el problema de fondo.
Procedencia
Para cada fuente deberías poder responder:
- qué sistema es el origen;
- quién mantiene los datos;
- cuándo se actualizaron;
- qué transformaciones sufrieron antes de llegar al modelo;
- qué sistema actúa como referencia cuando existen discrepancias.
La idea de source of truth sigue siendo útil. Si el CRM contiene una dirección y el ERP contiene otra, la arquitectura necesita una regla de precedencia. El LLM no debería improvisarla según cuál aparezca redactada de forma más convincente.
Calidad
Los datos reales traen equipaje: campos vacíos, fechas con formatos distintos, duplicados, documentos caducados, errores de codificación y valores que incumplen las reglas esperadas.
Guardrails · control previo al modelo
Valida lo que puedas antes de invocar la IA
Las comprobaciones que tienen una respuesta objetiva no necesitan delegarse al modelo. Estado del documento, versión o permisos pueden verificarse mediante reglas deterministas antes de consumir inferencia o permitir que el flujo continúe.
Validaciones deterministas
Antes del modelo- Regla 01 Documento vacío Detener → entrada_incompleta
- Regla 02 Versión inferior a la mínima Derivar → fuente_desactualizada
- Regla 03 Usuario sin permiso de lectura Denegar → sin_permiso
si documento == vacío:
    detener("entrada_incompleta")

si version_documento < version_minima:
    derivar("fuente_desactualizada")

si usuario.no_puede_leer(documento):
    denegar("sin_permiso")
Principio de diseño: si una condición puede resolverse con una regla explícita, verificable y reproducible, conviene evaluarla antes de llamar al modelo. Así reduces inferencias innecesarias y evitas que controles de acceso, integridad o vigencia dependan de una respuesta probabilística.
No hace falta convertir cada flujo en un compilador, pero resulta útil recordar cómo trabajan los compiladores: primero comprueban estructura y reglas; después intentan interpretar el programa. En IA empresarial tiene sentido hacer algo parecido.
Permisos y datos personales
El control de acceso debe aplicarse en la recuperación de información, no únicamente en la interfaz. Si un usuario no puede leer determinados registros salariales en el sistema de origen, una búsqueda vectorial no debería saltarse esa política por encontrar semánticamente pertinente un fragmento.
La AEPD ha señalado además que un prompt puede contener datos personales, documentación confidencial o secretos empresariales. Cuando se utilizan servicios externos, la organización necesita analizar qué información se envía, con qué finalidad, qué conserva el proveedor, quién puede acceder y qué garantías se aplican (AEPD, 2026).
Por eso merece la pena revisar, entre otros aspectos:
- minimización de la información enviada;
- roles y autorización;
- modalidad del servicio contratado;
- conservación de prompts y resultados;
- uso de información para entrenamiento;
- subproveedores;
- transferencias de datos cuando correspondan;
- anonimización o seudonimización cuando resulte adecuada.
Esto no convierte cada integración en un tratado jurídico. Significa que los permisos forman parte de la arquitectura, igual que la autenticación o el esquema de una tabla.
Trazabilidad: reconstruir una ejecución
Un sistema productivo debería permitir responder posteriormente a preguntas muy concretas:
- ¿qué entrada recibió?;
- ¿qué documentos recuperó?;
- ¿qué versión de esos documentos utilizó?;
- ¿qué servicio o modelo intervino?;
- ¿qué configuración relevante estaba activa?;
- ¿qué salida produjo?;
- ¿existió revisión humana?;
- ¿quién aprobó?;
- ¿qué acción terminó ejecutándose?;
- ¿cuál fue el resultado final?
No significa guardar indiscriminadamente todo durante años. La política de registro debe respetar las obligaciones aplicables de privacidad, seguridad y conservación. El objetivo técnico es disponer de una cadena auditable proporcional al proceso.
Un request_id o correlation_id que acompañe una ejecución entre servicios resulta especialmente útil. Cuando el CRM dice una cosa, el middleware otra y el ERP una tercera, ese identificador es el equivalente moderno al hilo rojo de Ariadna.
Integrar la solución con web, CRM, ERP u otras herramientas existentes
Veredicto técnico: Integrar IA en producción significa diseñar contratos entre sistemas, no limitarse a realizar llamadas HTTP. Debes gestionar autenticación, formatos, identificadores, latencia, reintentos, duplicados, estados parciales y recuperación. El modelo puede generar una respuesta correcta y el proceso completo terminar mal si la escritura posterior falla.
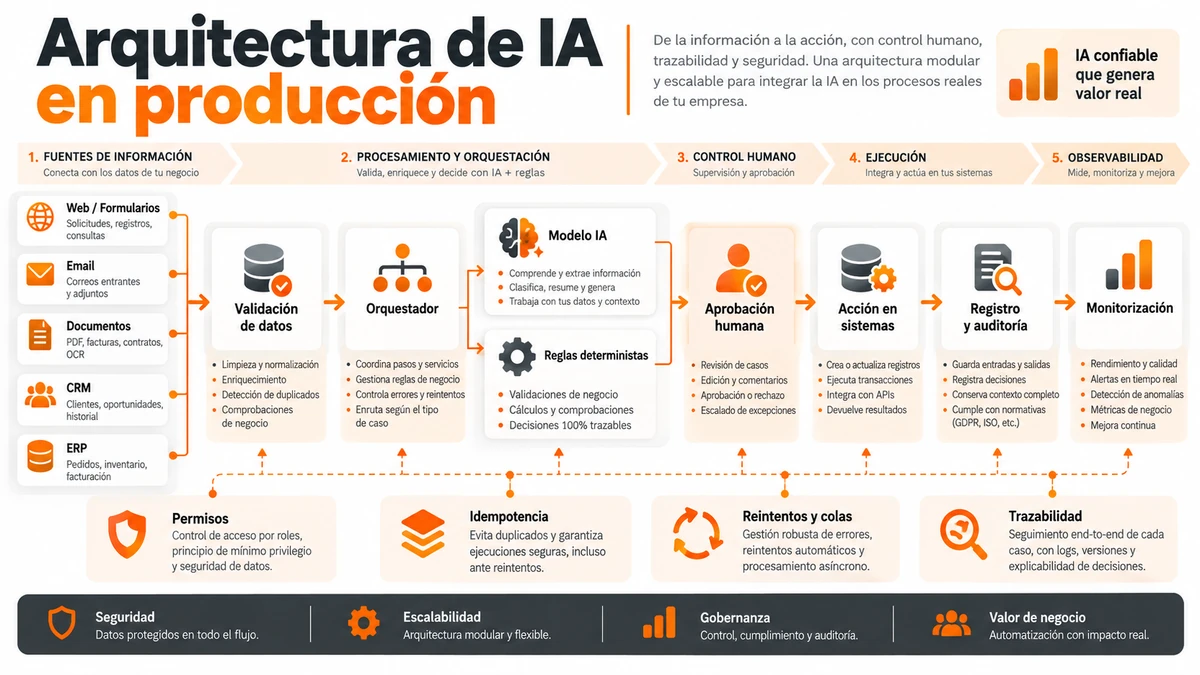
Imagina un flujo sencillo: un cliente envía una solicitud desde la web, el sistema consulta su ficha en el CRM, un modelo interpreta la petición y prepara una actualización para el ERP.
Sobre una diapositiva ocupa cuatro cajas y tres flechas. En producción empieza la fiesta.
La web puede emitir dos veces el mismo formulario. El CRM puede responder dentro de cinco segundos cuando tu timeout está configurado en tres. El modelo puede terminar correctamente y el ERP rechazar la escritura porque el registro quedó bloqueado. Entre una caja y otra aparecen los detalles que determinan la fiabilidad.
API, webhook y contrato de datos
Una API define cómo interactúan dos sistemas. Un webhook permite que una aplicación comunique un evento sin que el receptor tenga que preguntar continuamente si ha ocurrido algo.
Pero detrás necesitas contratos claros:
- autenticación;
- permisos y scopes;
- estructura del payload;
- identificadores;
- códigos de error;
- política de timeout;
- versión de API;
- esquema de respuesta;
- comportamiento ante reintentos.
Las salidas del modelo destinadas a otra máquina deberían utilizar estructuras validadas. Si el ERP espera un objeto con customer_id, category y action, pedir al LLM un párrafo y después intentar «adivinar» esos campos con expresiones regulares es una forma creativa de fabricar deuda técnica.
Idempotencia: ejecutar una vez aunque recibas dos peticiones
Integraciones · reintentos seguros
Idempotencia: cómo evitar que un reintento ejecute dos veces la misma operación
En una integración real, que una aplicación no reciba respuesta no significa necesariamente que el servidor no haya procesado la petición. Si el cliente reintenta sin protección, una operación aparentemente única puede producir efectos duplicados.
crear_factura(cliente=3821, importe=740)La segunda petición vuelve a ejecutar la modificación porque el receptor no puede distinguirla de una transacción nueva.
Todos los intentos correspondientes a la misma operación utilizan una clave única que permite al receptor reconocer que ya fue procesada.
idempotency_key = "factura-3821-2026-10-03-001"La idempotencia no impide los reintentos; los hace seguros. La aplicación puede volver a enviar una petición cuando desconoce el resultado anterior, mientras que el sistema receptor conserva suficiente estado para evitar que una misma intención de negocio genere varias modificaciones.
Reintentos, backoff y colas
Los reintentos son útiles para fallos temporales, pero deben estar acotados. Reintentar inmediatamente cien veces contra un servicio saturado sirve principalmente para asegurarse de que siga saturado.
El exponential backoff aumenta progresivamente el intervalo entre intentos. Añadir una pequeña variación aleatoria, conocida como jitter, reduce la probabilidad de que cientos de clientes vuelvan a atacar el mismo endpoint exactamente al mismo tiempo.
Procesamiento asíncrono · desacoplamiento
Una cola desacopla la entrada, el procesamiento de IA y las acciones posteriores
Cuando un proceso no necesita responder de inmediato, una cola permite aceptar el trabajo, procesarlo de forma independiente y decidir después si el resultado debe llegar a un sistema externo, pasar por revisión humana o derivarse a una ruta de error.
La cola convierte un proceso síncrono en una cadena de trabajo desacoplada: la entrada puede aceptarse sin esperar al resultado final, el procesamiento de IA se ejecuta de forma independiente y las acciones posteriores pueden distribuirse según su destino, necesidad de supervisión o estado de error.
Una Dead Letter Queue puede conservar mensajes que no se han podido procesar después de los intentos permitidos. Así una anomalía no tiene por qué bloquear toda la tubería.
¿Ejecutar o preparar?
IA en procesos · niveles de acción
No es lo mismo consultar información que ejecutar una acción final
La intervención de la IA puede situarse en distintos niveles: desde limitarse a leer datos hasta producir directamente un efecto sobre un sistema o proceso.
-
Lectura
Acción de la IA Consulta información.Ejemplo Recuperar la ficha de un cliente.
-
Recomendación
Acción de la IA Propone una acción.Ejemplo Sugerir una categoría.
-
Preparación
Acción de la IA Crea un borrador.Ejemplo Preparar una modificación del ERP.
-
Modificación
Acción de la IA Cambia un registro reversible.Ejemplo Actualizar una etiqueta.
-
Ejecución
Acción de la IA Produce un efecto final.Ejemplo Emitir una operación con consecuencias económicas.
La diferencia está en el tipo de acción: consultar, recomendar y preparar no producen el mismo efecto que modificar un registro o ejecutar una operación final. Separar estos niveles permite describir con mayor precisión qué puede hacer realmente la IA dentro de un proceso.
Esta decisión cambia radicalmente el riesgo del diseño.
Para muchos primeros despliegues, preparar un estado pendiente_aprobacion ofrece una frontera muy útil. Permite aprovechar la interpretación del modelo mientras la transición definitiva sigue dependiendo de una validación controlada.
Definir supervisión humana, validaciones y criterios de escalado
Qué debes saber: Supervisión humana no significa colocar a una persona mirando un dashboard. Debes decidir qué puede hacer el sistema por sí mismo, qué acciones requieren aprobación, qué señales provocan una derivación, quién puede detener la operación y cómo se registra cada decisión. El nivel de control debe responder al riesgo real del proceso.
Una aplicación que recomienda etiquetas para tickets no necesita el mismo mecanismo de control que un sistema capaz de modificar condiciones contractuales. La autonomía debería graduarse según las consecuencias.
Una escala práctica puede ser:
- Consultar: la IA recupera información.
- Recomendar: propone una decisión.
- Preparar: deja una acción lista para validar.
- Modificar: cambia información bajo límites definidos.
- Ejecutar: completa una operación con efectos relevantes.
A medida que aumenta la autonomía debes evaluar reversibilidad, coste del error, personas afectadas, naturaleza de los datos y contexto normativo.
Human-in-the-loop y human-on-the-loop
En un esquema Human-in-the-Loop (HITL), la ejecución se detiene hasta recibir una decisión humana. El sistema puede analizar y preparar, pero no completa la transición sin aprobación.
Human-in-the-loop · control por confianza
La confianza puede decidir qué casos automatizar y cuáles escalar a una persona
Un flujo supervisado puede permitir que la IA clasifique una solicitud y utilizar un umbral de confianza para decidir qué ocurre después. Los casos suficientemente claros siguen una ruta de preparación, mientras que los inciertos se derivan a revisión humana antes de actuar sobre el sistema.
El umbral de confianza no tiene por qué decidir directamente si se modifica el ERP. Puede utilizarse para decidir qué casos siguen un flujo automatizado de preparación y cuáles requieren revisión humana, manteniendo un punto de aprobación común antes de ejecutar la acción sobre el sistema.
En un esquema Human-on-the-Loop (HOTL), el proceso puede avanzar automáticamente dentro de límites definidos mientras una persona supervisa indicadores, excepciones y alertas, con capacidad para intervenir.
La investigación de Zhang, Liao y Bellamy sobre decisiones asistidas por IA muestra por qué el diseño de esta interfaz importa: proporcionar información sobre la confianza del sistema puede ayudar al usuario a calibrar mejor cuánto confiar en una recomendación, aunque esa calibración no garantiza por sí misma una mejor decisión conjunta (Zhang, Liao & Bellamy, 2020).
Esto invita a evitar interfaces que se limiten a mostrar una respuesta contundente. El revisor necesita contexto útil: fuente consultada, señales de incertidumbre, campos problemáticos y motivo de la derivación.
Los umbrales deben desembocar en acciones
Un valor de confianza guardado en un log no controla nada por sí solo. Debe activar comportamiento.
Por ejemplo:
- confianza alta + operación reversible → continuar;
- confianza media → generar borrador;
- confianza baja → derivar;
- fuente ausente → detener;
- dato protegido sin autorización → bloquear;
- volumen anómalo de errores → activar parada operativa.
No todos los sistemas permiten interpretar la «confianza» del mismo modo, por lo que estos umbrales deben validarse empíricamente para el caso de uso. En ocasiones resultará preferible combinar reglas, evaluaciones externas, controles de consistencia y revisión humana.
Responsabilidad funcional y técnica
Alguien debe ser propietario del proceso. «El equipo de IA» no es una responsabilidad suficientemente concreta.
El reparto puede distinguir:
Gobierno operativo · responsabilidades
Cada proceso de IA necesita responsables claros
Llevar un sistema a producción no consiste solo en asignar un responsable técnico. También debe quedar claro quién responde por el objetivo de negocio, quién valida las acciones y quién revisa de forma continua métricas, incidencias y desviaciones.
Propietario funcional
¿El proceso sigue cumpliendo su objetivo de negocio?
Responsable técnico
¿El sistema funciona, registra y se recupera correctamente?
Validador
¿Quién aprueba acciones que requieren intervención?
Responsable de seguimiento
¿Quién revisa métricas, incidencias y desviaciones?
La responsabilidad no debería concentrarse en una sola persona: negocio, operación técnica, validación y seguimiento responden a problemas distintos. Separar estas funciones facilita saber quién debe actuar cuando el proceso deja de cumplir su objetivo, falla técnicamente, requiere aprobación o empieza a desviarse de los resultados esperados.
El Reglamento de Inteligencia Artificial de la Unión Europea introduce requisitos específicos para determinadas categorías de sistemas. En los sistemas de alto riesgo sometidos a esos requisitos, el marco contempla registros automáticos de acontecimientos y medidas de supervisión humana proporcionales al riesgo, nivel de autonomía y contexto de uso (Parlamento Europeo y Consejo de la Unión Europea, 2024).
Eso no significa que cualquier chatbot empresarial tenga automáticamente las mismas obligaciones. La clasificación y el contexto de utilización importan. La conclusión de ingeniería, en cambio, sigue siendo útil fuera del ámbito regulado: trazabilidad y mecanismos claros de intervención reducen incertidumbre operativa.
Probar con indicadores verificables: tiempo, errores, derivaciones y adopción
Idea clave: Para demostrar que un piloto merece escalar necesitas comparar su comportamiento con una línea base definida antes de la evaluación. Mide operación, calidad, supervisión, adopción y coste con datos observables. Los criterios para ampliar el despliegue deben acordarse de antemano para evitar convertir impresiones favorables en una falsa prueba de rendimiento.
Antes de decir que la IA «ahorra tiempo», mide cuánto tardaba el proceso anterior. Antes de afirmar que «reduce errores», define qué cuenta como error y registra cuántos ocurrían sin la nueva solución.
Parece obvio, pero numerosos pilotos empiezan por construir y terminan intentando reconstruir a posteriori cómo funcionaba el proceso antiguo. Es como optimizar un programa en C sin haber pasado antes un profiler: puede que vaya más rápido, pero estás midiendo por intuición.
La línea base puede incluir:
- tiempo medio por tarea;
- distribución de tiempos, no únicamente el promedio;
- volumen procesado;
- errores detectados;
- tareas rechazadas;
- revisiones manuales;
- coste operativo;
- incidencias.
Métricas de operación
Sirven para comprobar si el sistema puede sostener el flujo real:
- tiempo por tarea;
- tiempo completo de ciclo;
- volumen procesado;
- latencia;
- porcentaje de ejecuciones completadas;
- disponibilidad del proceso.
Para sistemas distribuidos resulta útil mirar percentiles de latencia. Un promedio de 800 ms puede esconder que una fracción relevante de peticiones tarda varios segundos.
Métricas de calidad
El objetivo es saber si la salida cumple su función:
- errores fácticos;
- registros rechazados;
- correcciones humanas;
- campos incompletos;
- incumplimientos del formato;
- resultados que deben regenerarse.
La métrica debe relacionarse con el riesgo. Un error ortográfico en un borrador comercial y una cantidad incorrecta enviada a facturación pertenecen a categorías diferentes aunque ambos puedan contarse como «errores».
Métricas de supervisión
Estas métricas enseñan cuánto trabajo humano queda alrededor de la automatización:
- número de derivaciones;
- revisiones manuales;
- tiempo de revisión;
- excepciones;
- acciones revertidas;
- bloqueos por permisos o reglas.
Una reducción de tiempo del modelo pierde parte de su atractivo si genera una cola gigantesca de comprobaciones manuales.
Adopción y coste
También debes observar si las personas utilizan realmente el proceso:
- usuarios activos;
- frecuencia de utilización;
- abandono;
- porcentaje de tareas realizadas mediante el nuevo flujo;
- retorno voluntario al procedimiento anterior.
En modelos consumidos mediante API, añade coste por ejecución, consumo de tokens cuando sea relevante, llamadas externas y recursos de infraestructura. El coste interesante no es «cuánto cuesta la IA al mes», sino cuánto cuesta completar correctamente una unidad del proceso.
Define el gate antes de mirar el resultado
Un buen criterio de escalado puede adoptar esta forma:
ESCALAR SI:
- error grave < umbral acordado
- tiempo de ciclo < objetivo acordado
- coste por tarea dentro del presupuesto
- derivaciones dentro del rango operativo
- incidencias de integración dentro del límite
Los valores deben establecerse para cada proceso. Inventar un 2 %, un 95 % o cualquier otro número porque «suena razonable» sería justamente lo contrario de medir.
Piloto → producción · gate de escalado
¿Está realmente preparado el piloto de IA para escalar?
Evalúa los siete controles antes de considerar el paso a producción. El modelo puede funcionar correctamente y, aun así, existir bloqueos en datos, integración, excepciones, supervisión, métricas u operación.
- 01 · Caso de uso ¿Está claramente delimitado?
- 02 · Datos ¿Son adecuados, accesibles y autorizados?
- 03 · Integración ¿Funciona con los sistemas reales?
- 04 · Excepciones ¿Sabemos cuándo detener o derivar?
- 05 · Control humano ¿Está definido quién valida qué?
- 06 · Métricas ¿Se cumplen los criterios acordados?
- 07 · Operación ¿Hay responsable, documentación y mantenimiento?
Evaluación incompleta
Completa los siete controles antes de valorar el escalado del piloto.
ESCALAR: un piloto no está preparado únicamente porque el modelo responda bien. Datos, integración, excepciones, supervisión, métricas y mantenimiento deben funcionar como un único proceso. Este gate sirve como control operativo orientativo; no sustituye criterios técnicos, de seguridad o de gobierno específicos del proyecto.
Este gate resume bastante bien cómo pasar un piloto de IA a producción en una empresa: cada «bloqueo» identifica deuda que deberías resolver antes de aumentar volumen, autonomía o número de usuarios.
Documentar, formar al equipo, mantener y revisar tras el despliegue
En pocas palabras: Entrar en producción marca el comienzo del mantenimiento, no el final del proyecto. Modelos, prompts, documentos, APIs, permisos, aplicaciones y procesos internos cambian. La implantación necesita documentación versionada, formación de usuarios, observabilidad, responsables y revisiones periódicas capaces de detectar regresiones antes de que se conviertan en comportamiento normal.
Un sistema de IA empresarial combina piezas que evolucionan a ritmos distintos. El CRM cambia un campo. El proveedor de la API publica una versión. Se modifica una política interna. El modelo cambia. Un documento de conocimiento deja de estar vigente. Un usuario cambia de departamento y conserva un permiso que ya no debería tener.
Por eso el mantenimiento debe tratar la aplicación como software vivo.
La literatura sobre LLMOps incluye precisamente gestión del ciclo de vida, monitorización, versionado, infraestructura y actualización entre las tareas asociadas a operar modelos de lenguaje en entornos reales (Pahune & Akhtar, 2025).
Qué debería quedar documentado
La documentación útil no consiste en una presentación corporativa con flechas muy bonitas. Debe permitir que otro profesional entienda y opere el sistema.
Como mínimo, registra:
- mapa y estados del proceso;
- responsables funcionales y técnicos;
- fuentes de información;
- integraciones;
- métodos de autenticación;
- permisos y scopes;
- acciones autorizadas y prohibidas;
- excepciones conocidas;
- reglas de derivación;
- versiones de modelos o servicios;
- prompts y configuración relevante;
- pruebas automatizadas;
- métricas;
- procedimientos de rollback;
- incidencias y cambios.
Si la persona que construyó el piloto desaparece mañana y nadie puede explicar por qué existe una condición determinada, tienes conocimiento tribal disfrazado de arquitectura.
Formación de usuarios
Las personas que trabajan con el sistema necesitan entender su perímetro operativo:
- para qué pueden utilizarlo;
- qué tareas quedan fuera del caso autorizado;
- qué información pueden introducir;
- qué respuestas necesitan revisión;
- cómo detectar un resultado dudoso;
- dónde comunicar una incidencia;
- qué hacer cuando la automatización se detiene.
El artículo 4 del Reglamento de IA establece medidas de alfabetización en materia de IA para proveedores y responsables del despliegue, teniendo en cuenta conocimientos, experiencia y contexto de uso (Parlamento Europeo y Consejo de la Unión Europea, 2024).
Desde una perspectiva de ingeniería, además, formar al usuario mejora la calidad del sistema porque reduce entradas incorrectas y facilita detectar casos que todavía no estaban modelados.
Mantenimiento y regresiones
Cuando cambias un prompt, modelo o fuente RAG, no deberías asumir que todo sigue funcionando porque diez ejemplos continúan dando buen resultado.
Mantén un conjunto de pruebas representativas:
casos_normales/
casos_limite/
casos_ambiguos/
casos_sin_datos/
casos_sin_permiso/
casos_con_errores/
Después ejecuta esas pruebas cuando cambien componentes relevantes. Es la adaptación natural de las pruebas de regresión que el desarrollo de software lleva décadas utilizando.
También debes monitorizar:
- degradación de calidad;
- aumento de derivaciones;
- errores de integración;
- cambios de coste;
- latencia;
- adopción;
- modificaciones de permisos;
- cambios documentales;
- evolución de requisitos regulatorios aplicables.
La periodicidad dependerá de la naturaleza del proceso. Una herramienta interna de apoyo editorial y un sistema con capacidad de afectar decisiones sobre personas no necesitan el mismo régimen.
En implantaciones donde intervienen varias aplicaciones, fuentes de información y responsables, puede ser necesario coordinar perfiles de análisis, desarrollo, integración, analítica y mantenimiento. En ese contexto, el equipo de Presencia en Internet, marca comercial de Cis Net Solutions S.L. y con actividad en proyectos digitales desde 2003, puede encajar como uno de los participantes en esas fases, sin que ello sustituya la responsabilidad interna que la organización debe mantener sobre el proceso.
Cuándo está realmente preparado un piloto para escalar
Idea final: Un piloto está preparado para convertirse en proceso cuando puede operar con datos reales, integrarse con los sistemas necesarios, gestionar excepciones, respetar permisos, dejar trazabilidad, aplicar una supervisión proporcional y demostrar resultados frente a una línea base. Además, necesita responsables, documentación y un mecanismo de mantenimiento posterior.
La pregunta cómo pasar un piloto de IA a producción en una empresa tiene una respuesta menos exótica de lo que podría sugerir la tecnología: aplicando ingeniería de sistemas.
El modelo debe hacer bien su trabajo, por supuesto. Pero alrededor necesitas interfaces estables, esquemas validados, permisos, identificadores, registros, estados, idempotencia, rutas de error, métricas y personas que sepan cuándo intervenir. Son ideas familiares para cualquiera que haya construido software que debía seguir funcionando después de cerrar el portátil del desarrollador.
Antes de escalar un piloto, revisa si puedes explicar con precisión qué entra, qué sale, quién puede hacer qué, qué ocurre cuando algo falla y cómo demostrarías posteriormente lo sucedido. Después comprueba si las métricas acordadas justifican aumentar volumen o autonomía.
Si alguna de esas respuestas termina en «eso normalmente no pasa», probablemente acabas de encontrar el siguiente caso que deberías probar.
La IA aporta interpretación probabilística a procesos que antes resultaban difíciles de automatizar. La fiabilidad final, sin embargo, sigue dependiendo de una receta bastante clásica: datos, software, controles, medición y personas funcionando de manera coordinada. Ken Thompson probablemente no diseñó UNIX pensando en modelos generativos, pero la vieja máxima de construir sistemas comprensibles y composables sigue envejeciendo sorprendentemente bien.
Referencias consultadas:
- Agencia Española de Protección de Datos. (2026, 25 de agosto). Prompts, datos personales y confidencialidad: el nuevo perímetro de riesgo de la IA generativa. Laboratorio de Privacidad de la AEPD.
- Pahune, S., & Akhtar, Z. (2025). Transitioning from MLOps to LLMOps: Navigating the unique challenges of large language models. Information, 16(2), 87. doi:10.3390/info16020087.
- Parlamento Europeo y Consejo de la Unión Europea. (2024). Reglamento (UE) 2024/1689, de 13 de junio de 2024, por el que se establecen normas armonizadas en materia de inteligencia artificial (Reglamento de Inteligencia Artificial). Diario Oficial de la Unión Europea.
- Zhang, Y., Liao, Q. V., & Bellamy, R. K. E. (2020). Effect of confidence and explanation on accuracy and trust calibration in AI-assisted decision making. En Proceedings of the 2020 Conference on Fairness, Accountability, and Transparency. Association for Computing Machinery. doi:10.1145/3351095.3372852.